Fonctionnalités centrales d'ApiCatcher : introduction et scénarios d'utilisation
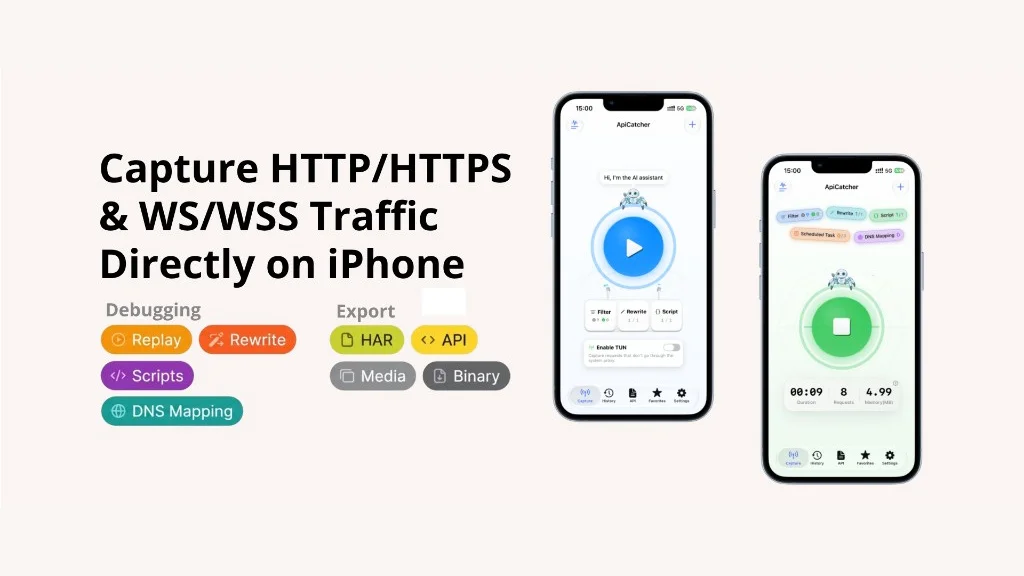
ApiCatcher capture et débogue le HTTP/HTTPS sur iOS, Android, macOS et Windows. Sur téléphone, le trafic passe par un VPN local : inutile de faire proxifier l’appareil par un ordinateur. Sur le bureau, on bascule entre le proxy système et le mode TUN. Le TUN sert aux applications qui ignorent le proxy système.
Le « Api » du nom vient du problème de départ : une requête capturée ne doit pas rester une ligne d’historique. Elle doit devenir une API qu’on peut réutiliser. Pour chacune des huit fonctions, on dit d’abord quel problème elle règle, puis les scénarios d’utilisation qui lui correspondent.
Capture
C’est l’entrée de tout le reste. Une fois lancée, le HTTP/HTTPS des apps et du navigateur passe par le proxy local. Après installation et confiance du certificat CA, le HTTPS se lit en clair. Les poignées de main et les trames WebSocket sont conservées. Les trames s’affichent comme une conversation, le JSON est coloré, et on peut chercher dans le payload.
Ce qui sert au quotidien :
- Listes d’autorisation et de refus, par hôte. Si la liste d’autorisation n’est pas vide, seuls les hôtes correspondants sont gardés. Ceux de la liste de refus ne sont pas enregistrés.
*fonctionne, par exemple*.example-api.com. - Sessions : du démarrage à l’arrêt, c’est une session. L’historique peut se limiter à cette capture, ou la session entière peut être supprimée.
- Recherche dans l’URL, les en-têtes de requête et de réponse, le corps de requête et le corps de réponse. On filtre aussi par méthode, protocole, Content-Type, code de statut et plage de temps.
- Export d’une requête en Raw, cURL ou Markdown, ou d’un lot en HAR. Images, vidéos et audio sont classés à part. Les fragments Range sont fusionnés avant l’export.
Scénario d'utilisation : dépannage des API. On refait une fois l’action qui a échoué, on ouvre cette requête dans l’historique, et on compare l’URL, les en-têtes et le corps réellement envoyés par le client avec le code et le corps renvoyés par le serveur. Une requête incorrecte vient du client. Une requête correcte avec une mauvaise réponse vient du serveur. On tranche ça avant d’aller plus loin.
Scénario d'utilisation : quelles API une fonction appelle. On refait la fonctionnalité une fois pour chaque scénario métier. L’historique montre alors quelles API ont été touchées, et en quoi les paramètres changent d’un scénario à l’autre.
Documentation d’API générée
Les requêtes HTTP/HTTPS qui conviennent deviennent une documentation d’API, groupée par hôte. Une opération se reconnaît par méthode + hôte + chemin. Les captures suivantes de la même opération n’ajoutent que les champs qui n’étaient pas encore là. Elles n’écrasent pas les champs déjà documentés lors des captures précédentes. L’exemple de réponse n’est mis à jour que si le statut est 200.
On exporte un hôte entier, une seule API, ou un dossier de favoris, vers Postman, Apifox, ou un ZIP Bruno.
Scénario d'utilisation : export vers un outil de gestion d’API. Une fois les documents générés, on exporte l’hôte, une API ou un dossier de favoris vers Postman, Apifox ou Bruno, pour les maintenir et les partager là-bas.
Contrairement à un export HAR réimporté dans Postman ou un outil du même type, la doc générée par ApiCatcher s’enrichit au fil des captures : plus vous couvrez de scénarios métier, plus les champs documentés sont complets.
Rejeu
Le rejeu, c’est ApiCatcher qui redevient le client. Il reprend une requête HTTP/HTTPS de l’historique, modifie ou non la query, les en-têtes et le corps, l’envoie au serveur, et affiche le statut et la réponse sur la page de rejeu. L’app ne se rafraîchit pas pour autant. Pour le WebSocket, on se reconnecte ici, on envoie une trame à la main et on lit la réponse.
Si la capture tourne, le rejeu passe par le proxy local. Les règles de réécriture et les scripts s’appliquent donc, et l’appel réapparaît dans l’historique.
Scénario d'utilisation : intégration d’API. Une fois que le backend a corrigé l’API, ou y a ajouté des logs pour chercher la cause, on rejoue en un geste la requête capturée. Ce seul envoi dit si le problème est réglé, et fait passer l’appel dans les nouveaux logs.
Rejeu combiné
Le rejeu combiné place plusieurs requêtes HTTP/HTTPS sur un canevas et les exécute selon leurs dépendances. Les nœuds sans dépendance entre eux partent en parallèle. Ceux qui en ont partent dans l’ordre : l’étage suivant ne démarre que lorsque le précédent a entièrement réussi.
Quatre actions reviennent tout le temps :
| Action | Rôle |
|---|---|
| Paramètres prévus | Query, en-têtes et corps fixés à l’avance sur chaque nœud |
| Dépendance | Un trait veut dire que l’aval attend l’amont, qui part en premier |
| Injection | Une valeur de la réponse amont est placée dans les en-têtes, la query ou le corps de la requête suivante |
| Expressions | ${method.timestamp()} et ${method.uuid()} sont remplacés au moment de l’exécution. Une valeur partagée comme ${token} se saisit sur la page d’exécution |
Scénario d'utilisation : intégration d’une chaîne d’appels. La requête suivante a besoin de la réponse précédente. On pose la dépendance, on injecte la réponse amont dans la requête aval, et l’exécution suit cet ordre. Par exemple, GET /user dépend de POST /login, et POST /order dépend de GET /user. On injecte le token dans Authorization sur les deux dernières, et l’ordre est connexion, profil, commande.
Scénario d'utilisation : même API, entrées différentes. On ajoute la requête plusieurs fois. S’il faut les enchaîner, on aligne tous les nœuds (dépendance seulement, sans injection). Chaque nœud reçoit son corps via les paramètres prévus. On compare ensuite les résultats. Par exemple, on ajoute trois fois la connexion : compte valide, mot de passe faux, mot de passe vide.
Réécriture
La réécriture modifie le trafic avant que la requête n’atteigne le serveur, ou avant que la réponse ne revienne à l’app. Une règle, c’est un périmètre plus une action. Le périmètre est un hôte, avec un chemin et une méthode facultatifs.
Actions :
- Redirection : envoyer un domaine de production vers la machine locale ou la préproduction.
- Mock : ne pas envoyer la vraie requête, et renvoyer un statut, des en-têtes et un corps prévus.
- Abandon de la requête / de la réponse : simuler un envoi qui ne part pas, ou un serveur qui ne répond jamais.
- Délai : retenir la réponse pour voir le chargement et le timeout sur un réseau lent.
- Modification : changer les en-têtes, remplacer tout le corps, ou substituer une partie du corps par expression régulière. L’expression peut être rédigée par l’IA à partir d’une phrase.
Scénario d'utilisation : mock d’une API. Le backend n’est pas prêt, ou le client doit arriver dans un état précis. On renvoie un statut et un corps prévus, sans appel réel. Par exemple, une liste de commandes avec « à payer » et « terminée » : les écrans avancent, et on coupe la règle quand l’API existe.
Scénario d'utilisation : réécriture de la réponse. On modifie quelques champs et on regarde la suite côté client, sans toucher aux données du serveur. Par exemple, remplacer "balance": 100 par "balance": 0 et voir le bouton quand le solde est à zéro.
Scripts
Quand la valeur change à chaque appel, une règle fixe ne suffit plus. On passe en JavaScript. Une requête qui correspond entre dans interceptRequest, la réponse dans interceptResponse. On l’écrit soi-même, on la fait rédiger par l’IA, ou on indique une URL de script sur le réseau local, distribuée par l’équipe.
Disponible dans le script :
cryptopour MD5, SHA, HMAC et Base64, pour signer ou chiffrer et déchiffrer un corps.localStorepour garder un token ou un autre état d’une requête à l’autre.httpClientpour faire un autre appel HTTP depuis le script, par exemple se reconnecter quand le token a expiré.
Scénario d'utilisation : calcul dynamique de la requête. Une signature ou un horodatage change à chaque appel : un remplacement fixe ne suit pas. On calcule à partir de cette requête, puis on laisse passer. Par exemple, si le rejeu renvoie toujours 401, on fait un HMAC de l’heure et du corps et on renseigne X-Timestamp et X-Signature. La capture doit déjà tourner avant le rejeu, sinon le script ne s’applique pas à cet appel.
Scénario d'utilisation : chiffrement et déchiffrement du corps. Les projets internes chiffrent souvent le corps en plus du HTTPS. Une fois TLS ouvert, on voit encore du chiffre. Le script chiffre avant l’envoi et déchiffre au retour, pour lire et modifier le clair. Par exemple, déchiffrer le corps de réponse dans interceptResponse. Au rejeu, rechiffrer le clair modifié dans interceptRequest avant l’envoi. Sans capture déjà lancée, le script ne s’exécute pas.
Usurpation DNS
Dans le produit, cela s’appelle mapping DNS. L’usurpation se fait dans le proxy. On ne touche ni au fichier hosts, ni au DNS du Wi-Fi. Pendant la capture, une connexion qui correspond saute la résolution publique et ouvre le TCP vers l’IP indiquée. L’en-tête Host et le SNI TLS restent le nom d’origine : l’app ne s’en aperçoit pas. Les jokers fonctionnent, par exemple *.apicatcher.net.
Scénario d'utilisation : même domaine pour test ou préproduction. Le test, la préproduction et la production partagent le même domaine. On atteint le test ou la préproduction en faisant pointer ce domaine vers le bon environnement. On le mappe vers l’IP de test ou de préproduction. Cela prend effet au démarrage de la capture : plus besoin de changer le DNS du Wi-Fi à chaque fois, et plus de cache DNS système à combattre.
Tâches planifiées
Une tâche exécute un rejeu, ou un rejeu combiné entier, selon un planning.
- Cron : six champs, dans l’ordre seconde, minute, heure, jour, mois, jour de la semaine.
0 * * * * ?veut dire la seconde 0 de chaque minute. En cas de doute, l’IA l’écrit à partir d’une phrase. - Personnalisé : répétition toutes les N secondes, avec un nombre maximal d’exécutions ou une durée en minutes.
La tâche s’arrête quand une condition d’arrêt automatique correspond. L’historique montre la durée et le taux de succès. Sur téléphone, la capture doit être lancée pour que la tâche tourne. Sur le bureau, il suffit que l’application soit ouverte.
Scénario d'utilisation : envoi planifié. La fenêtre est trop courte, un clic à la main la rate facilement. On envoie une requête, ou un rejeu combiné, à intervalle régulier, et on s’arrête selon la réponse. Par exemple, quelques secondes avant une vente flash, une commande chaque seconde. On stoppe quand code vaut 200, ou quand le corps indique que l’achat a réussi ou que la vente est finie.
Scénario d'utilisation : contrôle planifié. On rappelle la même API à un rythme fixe, pour voir si elle répond et si elle ralentit. Un contrôle de santé en cron 0 * * * * ? part une fois par minute. On ne met pas d’arrêt automatique, et on lit le P95 dans l’historique.
Scénario d'utilisation : régression planifiée. On planifie un rejeu combiné déjà construit, et on regarde si les résultats collent encore à ce qu’on attend. On ajoute plusieurs fois la même API, avec une entrée différente prévue sur chaque nœud. Ces nœuds sont les cas de test. On lance ce combiné une fois par semaine. Si les appels exigent d’abord une connexion, on ajoute une seule requête de login comme prédécesseur commun de toutes les autres. Ces autres requêtes ne peuvent alors partir qu’en parallèle entre elles.
Le détail des manipulations : manuel, réécriture, scripts, rejeu combiné, tâches planifiées.
Les fonctions évoquées ici ne couvrent pas tout ApiCatcher. Pour le reste, consultez le site officiel. Les scénarios d’utilisation listés ne limitent pas ces fonctions à ces cas : ils illustrent les problèmes que nous voulions résoudre en les créant.